圖解Kafka 數(shù)據(jù)處理與存儲服務(wù)的核心設(shè)計
Kafka作為一個高吞吐量、可水平擴展的分布式流數(shù)據(jù)平臺,其數(shù)據(jù)處理與存儲服務(wù)的核心設(shè)計是其成功的關(guān)鍵。本文將通過圖解的方式,深入淺出地解析Kafka如何高效地存儲和處理海量數(shù)據(jù)。
一、 數(shù)據(jù)模型:主題、分區(qū)與偏移量
Kafka的數(shù)據(jù)組織圍繞三個核心概念:主題(Topic)、分區(qū)(Partition)和偏移量(Offset)。
- 主題: 可以理解為一個數(shù)據(jù)流或類別的名稱,例如“userclicklogs”。生產(chǎn)者將消息發(fā)送到特定主題,消費者從主題訂閱消息。
- 分區(qū): 每個主題可以被分割成一個或多個分區(qū)。分區(qū)是Kafka實現(xiàn)水平擴展和并行處理的基礎(chǔ)。
- 偏移量: 在每個分區(qū)內(nèi)部,每條消息都會被分配一個唯一的、連續(xù)遞增的ID,稱為偏移量(Offset)。它標(biāo)識了消息在分區(qū)內(nèi)的位置。消費者通過管理自己消費的偏移量來追蹤進度。
(圖解示意:一個名為“Topic-A”的圓柱體被縱向切分成三個分區(qū)Partition 0/1/2,每個分區(qū)內(nèi)部都有一條從0開始向上增長的刻度線,代表偏移量。)
二、 物理存儲:日志段與索引
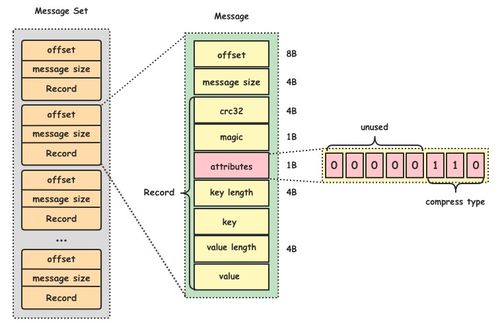
Kafka的存儲設(shè)計極其簡潔高效,其核心是“僅追加日志”(Append-Only Log)。
- 分區(qū)即目錄: 在Broker(服務(wù)器)的磁盤上,每個分區(qū)對應(yīng)一個文件夾。命名規(guī)則通常為
<topic>-<partition>,例如topic-a-0。 - 日志段文件: 分區(qū)文件夾下并非一個巨大的文件,而是被切分成多個大小相等的“日志段”(Log Segment)。當(dāng)前正在寫入的段稱為活躍段。當(dāng)活躍段達到配置的大小(如1GB)或時間后,就會滾動創(chuàng)建一個新的活躍段,舊段變?yōu)橹蛔x。
- 索引文件: 為了快速定位消息,Kafka為每個日志段維護了兩個稀疏索引文件:
- 位移索引(.index): 建立了消息偏移量到其在日志文件中物理位置的映射。
- 時間戳索引(.timeindex): 建立了時間戳到偏移量的近似映射,支持按時間戳查找。
(圖解示意:一個名為“topic-a-0”的文件夾,內(nèi)部包含多個成對的文件:00000000000000000000.log, 00000000000000000000.index, 00000000000000000000.timeindex;00000000000000001000.log, .index, .timeindex... 文件編號代表該段起始偏移量。)
三、 寫入流程:高效追加與持久化
- 順序?qū)懭?/strong>: 生產(chǎn)者發(fā)送的消息被嚴格按到達順序追加到當(dāng)前活躍日志段的末尾。磁盤的順序?qū)懭胨俣葮O快,這是Kafka高吞吐量的重要原因。
- 頁緩存: 數(shù)據(jù)首先寫入操作系統(tǒng)的頁緩存(Page Cache),而非直接刷盤。這利用了現(xiàn)代操作系統(tǒng)的內(nèi)存管理優(yōu)勢,效率極高。
- 刷盤策略: Kafka通過配置(
flush.messages和flush.ms)來控制何時將頁緩存中的數(shù)據(jù)同步(fsync)到物理磁盤。通常依賴操作系統(tǒng)后臺刷盤,在性能和持久性之間取得平衡。
(圖解示意:一條消息從“生產(chǎn)者”出發(fā),進入Broker內(nèi)存的“頁緩存”,然后被“追加”到當(dāng)前活躍的.log文件末尾,最后通過一個可配置的“刷盤控制器”決定何時同步到“物理磁盤”。)
四、 讀取流程:零拷貝與高效檢索
- 消費者定位: 消費者指定要消費的主題、分區(qū)以及起始偏移量。
- 索引查找: Broker首先根據(jù)目標(biāo)偏移量找到對應(yīng)的日志段文件,然后使用該段的
.index文件進行二分查找,定位到消息在.log文件中的精確位置。 - 零拷貝傳輸: 這是Kafka高性能的另一個關(guān)鍵。當(dāng)Broker將磁盤上的日志數(shù)據(jù)發(fā)送給消費者時,它利用操作系統(tǒng)的
sendfile系統(tǒng)調(diào)用,數(shù)據(jù)直接從頁緩存經(jīng)由網(wǎng)卡緩沖區(qū)發(fā)送到網(wǎng)絡(luò),避免了在內(nèi)核空間和用戶空間之間的多次拷貝,極大降低了CPU開銷和延遲。
(圖解示意:一個“消費者”請求Offset=1005的消息。Broker先通過索引定位到它在00001000.log文件中,然后通過“零拷貝(sendfile)”路徑,數(shù)據(jù)從“頁緩存”直接經(jīng)由“網(wǎng)卡”發(fā)送給消費者,繞開了“用戶緩沖區(qū)”。)
五、 數(shù)據(jù)處理服務(wù):生產(chǎn)者與消費者模型
Kafka自身不直接處理業(yè)務(wù)邏輯,而是為上下游應(yīng)用提供了強大的數(shù)據(jù)處理管道。
- 生產(chǎn)者API: 負責(zé)將數(shù)據(jù)發(fā)布到Kafka集群。支持異步發(fā)送、批量發(fā)送、壓縮、重試和自定義分區(qū)策略,以優(yōu)化吞吐量和可靠性。
- 消費者API: 支持以單線程、多線程或消費者組(Consumer Group)的方式從主題拉取數(shù)據(jù)。消費者組是實現(xiàn)“一個分區(qū)只能被組內(nèi)一個消費者消費”的負載均衡和容錯機制的關(guān)鍵。
- 流處理集成: 通過Kafka Streams或與Flink/Spark Streaming等流處理框架集成,Kafka可以構(gòu)成完整的流處理管道,實現(xiàn)實時轉(zhuǎn)換、聚合和計算。
(圖解示意:左側(cè)多個“生產(chǎn)者”將數(shù)據(jù)流推入Kafka集群(由多個Broker組成)。右側(cè),兩個“消費者組”(Group A和Group B)從集群拉取數(shù)據(jù)。Group A有3個消費者實例,均衡消費3個分區(qū);Group B有1個消費者實例,消費所有分區(qū)數(shù)據(jù)。)
Kafka的數(shù)據(jù)存儲與處理設(shè)計,巧妙地結(jié)合了順序I/O、頁緩存、稀疏索引、零拷貝等底層系統(tǒng)優(yōu)勢,構(gòu)建了一個高吞吐、低延遲、可持久化且易于水平擴展的消息系統(tǒng)。其“分區(qū)”和“消費者組”的設(shè)計,完美支撐了現(xiàn)代大數(shù)據(jù)架構(gòu)中并行處理和容錯的需求,使其成為流數(shù)據(jù)平臺不可或缺的核心組件。
如若轉(zhuǎn)載,請注明出處:http://m.europeshares.cn/product/54.html
更新時間:2026-10-22 13:11:23