揭秘LinkedIn大數(shù)據(jù)后臺的運作機制 從數(shù)據(jù)庫到數(shù)據(jù)處理和存儲服務
LinkedIn作為全球領先的職業(yè)社交平臺,其大數(shù)據(jù)后臺系統(tǒng)在支撐著數(shù)億用戶的日常互動和數(shù)據(jù)管理。該系統(tǒng)的核心依賴于高效的數(shù)據(jù)信架構(gòu)、先進的數(shù)據(jù)處理技術(shù)以及可靠的存儲服務。以下將詳細解析LinkedIn大數(shù)據(jù)后臺的運作流程。
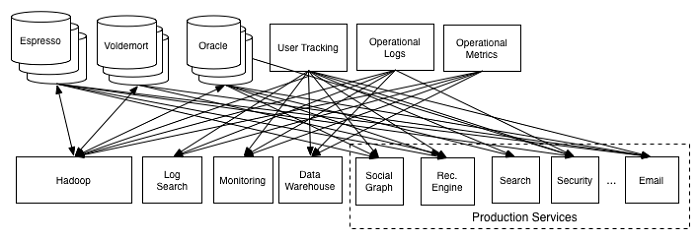
LinkedIn采用分布式數(shù)據(jù)信系統(tǒng)來管理海量數(shù)據(jù)。該平臺早期使用關(guān)系型數(shù)據(jù)信,但隨著數(shù)據(jù)量的激增,逐步遷移到NoSQL和NewSQL解決方案,如Apache Kafka用于實時數(shù)據(jù)流處理,以及Voldemort和Espresso等自研數(shù)據(jù)信系統(tǒng)。這些系統(tǒng)支持高可用性和水平擴展,確保用戶資料、連接關(guān)系和活動日志等數(shù)據(jù)能夠快速讀寫和查詢。
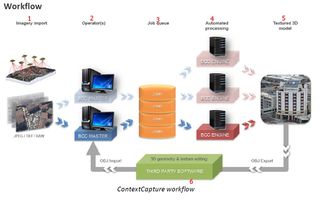
數(shù)據(jù)處理是后臺運作的關(guān)鍵環(huán)節(jié)。LinkedIn使用Apache Hadoop和Apache Spark等開源框架進行批處理和實時計算。例如,通過Spark Streaming處理用戶行為數(shù)據(jù),生成個性化推薦和洞察報告。數(shù)據(jù)管道還包括ETL(提取、轉(zhuǎn)換、加載)過程,將原始數(shù)據(jù)轉(zhuǎn)化為結(jié)構(gòu)化格式,用于分析和機器學習模型訓練,從而優(yōu)化用戶體驗和業(yè)務決策。
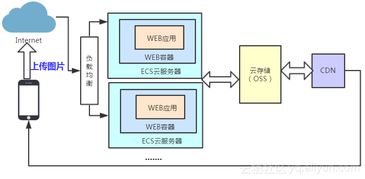
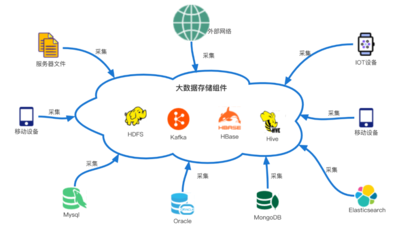
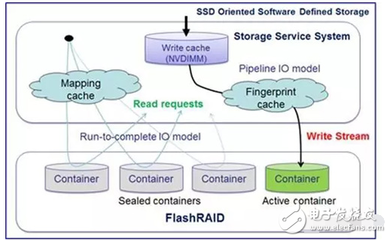
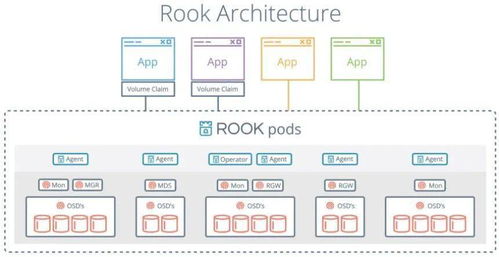
存儲服務方面,LinkedIn結(jié)合了多種存儲技術(shù)。對象存儲用于處理非結(jié)構(gòu)化數(shù)據(jù),如用戶上傳的文檔和圖片,而分布式文件系統(tǒng)如HDFS則用于大數(shù)據(jù)集的長期存儲。通過火龍果軟件工程等專業(yè)服務,LinkedIn實現(xiàn)了數(shù)據(jù)處理和存儲的自動化監(jiān)控與優(yōu)化,確保系統(tǒng)在高并發(fā)場景下的穩(wěn)定性和性能。
LinkedIn大數(shù)據(jù)后臺通過整合先進的數(shù)據(jù)庫技術(shù)、高效的數(shù)據(jù)處理流程和可靠的存儲服務,構(gòu)建了一個可擴展、高可用的生態(tài)系統(tǒng)。這不僅提升了平臺的響應速度,還為持續(xù)創(chuàng)新和數(shù)據(jù)驅(qū)動決策奠定了堅實基礎。
如若轉(zhuǎn)載,請注明出處:http://m.europeshares.cn/product/6.html
更新時間:2026-10-22 07:46:53